Guide pratique pour automatiser les bonnes pratiques Git — contrôle du code, des messages de commit, des noms de branche et des secrets — avant qu'ils n'atteignent le dépôt partagé.
Document généraliste : la configuration est donnée en version générique et peut être adaptée selon la stack du projet (modèles de données, SQL/dbt, Python, etc.).
Le problème
Trois situations reviennent sur la plupart des projets, quel que soit le niveau de l'équipe :
- Des conventions qui ne sont pas respectées. Elles sont documentées, mais pas appliquées : turnover, pas d'autorité hiérarchique, ou simplement la fatigue en fin de journée.
- Du code non maîtrisé. Généré par IA, copié, ou écrit dans l'urgence — il casse en production à la montée en charge.
- Un diff illisible. Branches
test_truc, commitsupdate, personne ne sait ce qui a changé ni pourquoi.
La racine commune : tout arrive trop tard, au moment où le code est déjà partagé. La discipline individuelle ne suffit pas. La solution est de déplacer le contrôle au moment où l'erreur est commise, et de le rendre bloquant.
Deux sens pour « pre-commit »
- Le hook Git
pre-commit: un script exécutable dans.git/hooks/, déclenché à chaquegit commit. Git définit 24 points d'accroche de ce type (pre-commit,commit-msg,pre-push,pre-rebase…). - Le framework
pre-commit: un gestionnaire d'environnements de hooks (pip install pre-commit) qui installe et exécute des contrôles dans ces points d'accroche, depuis un fichier versionné.pre-commit-config.yaml.
Pourquoi le framework plutôt que des scripts bash à la main :
Script bash dans .git/hooks/ |
Framework pre-commit |
|---|---|
| Pas versionné → invisible pour les nouveaux | .pre-commit-config.yaml commité avec le code |
| Chemins en dur, dépendances locales → non portable | Chaque hook tourne dans un environnement isolé, recréé depuis son dépôt |
| Aucune mise à jour | Versions figées par rev:, mises à jour par pre-commit autoupdate |
Un nouveau développeur fait git clone puis pre-commit install : il a exactement les mêmes contrôles que l'équipe. C'est ce qui fait survivre une convention au turnover.
Le bon contrôle au bon moment
Les hooks qui comptent, et leur différence temporelle (c'est elle qui décide où mettre quoi) :
| Hook | Déclenché par | Peut bloquer ? | Fréquence |
|---|---|---|---|
pre-commit |
git commit |
Oui — code non nul = commit annulé | à chaque commit |
commit-msg |
git commit, après le message |
Oui — commit annulé | à chaque commit (fichier de 2 lignes, instantané) |
pre-push |
git push |
Oui — push annulé | une fois par branche |
pre-rebase |
git rebase |
Oui | rare |
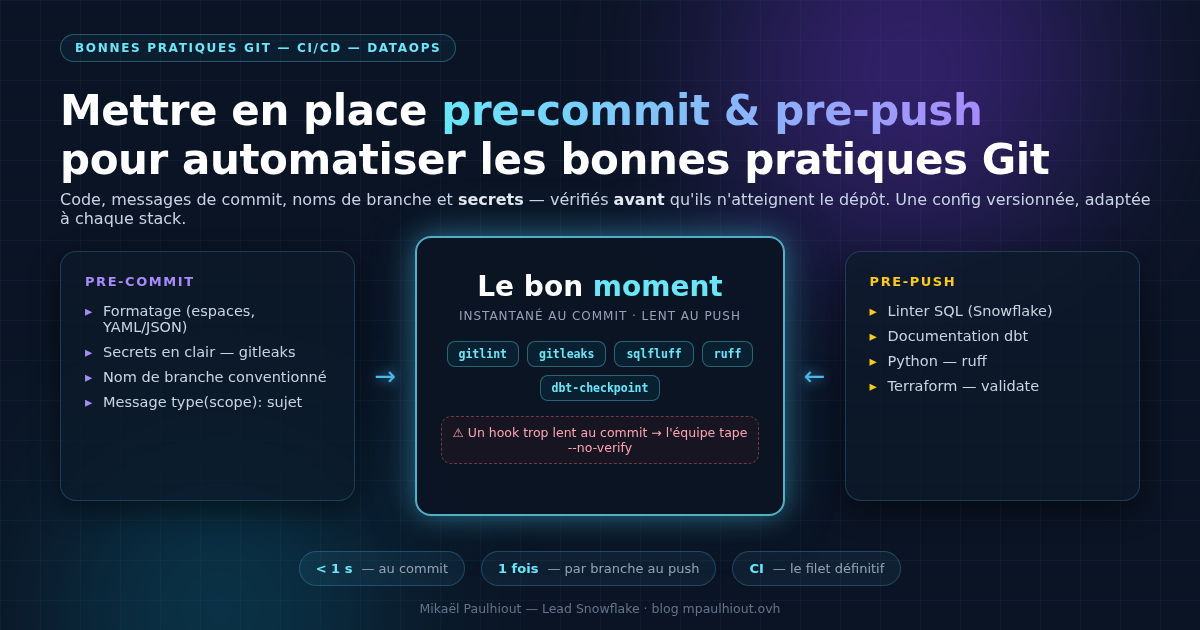
Règle d'or : ce qui est instantané va au commit, ce qui est lent va au push.
- En
pre-commit/commit-msg(< 1 seconde) : formatage, secrets, message de commit, nom de branche. - En
pre-push(plus lent, une fois par branche) : linter SQL, documentation, compilation, validation de schéma. - En CI : le même fichier rejoué comme garantie.
Mettre un linter lourd en pre-commit fait attendre plusieurs secondes à chaque commit ; au bout de trois jours tout le monde contourne avec --no-verify. C'est le mode d'échec à éviter.
Ce qu'on met où
| Contrôle | Hook | Pourquoi là |
|---|---|---|
| Espaces en fin de ligne, newline finale, YAML cassé, JSON cassé, gros fichiers, conflits de merge, clé privée | pre-commit |
instantané |
| Détection de secrets (identifiants, tokens) | pre-commit |
le seul contrôle qui ne doit jamais être contourné |
| Nom de branche conventionné | pre-commit |
évite les test_truc |
Message de commit (type(scope): sujet) |
commit-msg |
seule place où le message est vérifiable |
| Linter SQL, documentation, compilation | pre-push |
lent, une fois par branche |
| Même config rejouée sur le serveur | CI | le filet définitif |
Configuration de base
Le fichier .pre-commit-config.yaml
# .pre-commit-config.yaml
default_stages: [pre-commit]
minimum_pre_commit_version: "4.0.0"

repos:
  # --- Contrôles de forme : instantanés, à chaque commit ---
  - repo: https://github.com/pre-commit/pre-commit-hooks
    rev: v6.0.0
    hooks:
      - id: trailing-whitespace        # espaces en fin de ligne
      - id: end-of-file-fixer          # newline finale manquante
      - id: check-yaml                 # YAML cassé
      - id: check-json                 # JSON cassé (modèles, configs)
      - id: check-merge-conflict       # marqueurs
      - id: check-added-large-files    # gros fichier commité par erreur
      - id: check-case-conflict        # collision case-insensitive
      - id: detect-private-key         # clé privée en clair
      - id: no-commit-to-branch
        args: [--branch, main, --branch, master, --branch, develop]

  # --- Convention de nommage des branches ---
  - repo: local
    hooks:
      - id: branch-name
        name: nom de branche <type>/<sujet>
        entry: scripts/check_branch_name.sh
        language: script
        pass_filenames: false
        always_run: true

  # --- Détection de secrets : à chaque commit, sur le diff indexé ---
  - repo: https://github.com/gitleaks/gitleaks
    rev: v8.30.1
    hooks:
      - id: gitleaks

  # --- Convention de message de commit ---
  - repo: https://github.com/jorisroovers/gitlint
    rev: v0.19.1
    hooks:
      - id: gitlint
        stages: [commit-msg]
La convention de message (.gitlint)
Deux variantes selon la convention du projet :
Variante A — Conventional Commits standard :
# .gitlint
[general]
contrib = contrib-title-conventional-commits
ignore = B6,B5,body-min-length
ignore-merge-commits = true
ignore-fixup-commits = true
regex-style-search = true

[title-max-length]
line-length = 100
Variante B — types personnalisés :
# .gitlint — types personnalisés
[general]
ignore = B6,B5,body-min-length
ignore-merge-commits = true
ignore-fixup-commits = true
regex-style-search = true

[title-match-regex]
regex = ^(feat|fix|rename|doc|reveng)\([a-z0-9_-]+\): .+
Comportement :
git commit -m "ajout objet invoicing"              # → refusé (pas de type)
git commit -m "feat(gdm): ajout objet invoicing"   # → accepté
git commit -m "wip: sauvegarde en vrac"            # → refusé (type hors liste)
À adapter : la regex de la variante B est le seul endroit à modifier si la convention de types change.
Le nommage des branches
#!/usr/bin/env bash
# scripts/check_branch_name.sh — refuse un nom de branche hors convention
set -euo pipefail
PATTERN='^(feat|fix|rename|doc|reveng|feature)/[a-z0-9._-]+$'
BRANCH=$(git rev-parse --abbrev-ref HEAD)

if [ "$BRANCH" = "HEAD" ]; then
    exit 0        # rebase en cours : HEAD détaché, rien à valider
fi

if ! printf '%s' "$BRANCH" | grep -qE "$PATTERN"; then
    printf 'Nom de branche refusé : %s\n' "$BRANCH"
    printf 'Attendu : <type>/<sujet>, ex. feat/invoicing\n'
    exit 1
fi
Trois détails qui comptent :
entrypointe vers un fichier versionné, pas dubash -cinline : le script apparaît dans la revue quand on le modifie.pass_filenames: false: le hook raisonne sur l'état du dépôt, pas sur les fichiers modifiés.always_run: true: sans ça, le hook est sauté quand aucun fichier ne correspond à son filtre.
L'installation (le piège silencieux)
# 1. Installer le framework (dans un venv de projet, pas le Python système)
pip install pre-commit

# 2. Installer les scripts dans .git/hooks/
#    Sans --hook-type, SEUL pre-commit est installé.
#    Tout ce qui est en stages: [pre-push] ou [commit-msg] ne s'exécutera JAMAIS, en silence.
pre-commit install --hook-type pre-commit --hook-type commit-msg --hook-type pre-push

# 3. Passer tous les hooks sur l'existant (une seule fois)
pre-commit run --all-files
Si le venv disparaît (machine reformatée), le hook pointe dans le vide et Git échoue à chaque commit : un simple pre-commit install répare.
Adapter à la stack du projet
La configuration de base se complète selon ce que le projet manipule. Les blocs ci-dessous sont optionnels — on n'active que ceux qui correspondent.
SQL / dbt
  # Linter SQL — le dialecte se déclare explicitement
  - repo: https://github.com/sqlfluff/sqlfluff
    rev: 4.4.0
    hooks:
      - id: sqlfluff-lint
        args: [--dialect, snowflake]
        stages: [pre-push]

  # Documentation des modèles dbt (lit target/manifest.json → lancer `dbt parse` avant)
  - repo: https://github.com/dbt-checkpoint/dbt-checkpoint
    rev: v2.0.10
    hooks:
      - id: check-model-has-description
      - id: check-model-columns-have-desc
        stages: [pre-push]
Fichier SQLFluff minimal (le templater Jinja est indispensable sur un projet dbt) :
# .sqlfluff
[sqlfluff]
dialect = snowflake
templater = jinja
max_line_length = 120

[sqlfluff:templater:jinja]
apply_dbt_builtins = True
Python
  - repo: https://github.com/astral-sh/ruff-pre-commit
    rev: v0.16.10
    hooks:
      - id: ruff-check
      - id: ruff-format
        stages: [pre-push]
Infra / Terraform
  - repo: https://github.com/antonbabenko/pre-commit-terraform
    rev: v1.109.2
    hooks:
      - id: terraform_fmt
      - id: terraform_validate
        stages: [pre-push]
La CI : un hook local est un service, pas une garantie
Un hook local tourne sur la machine du développeur, il est contournable (--no-verify) donc non opposable. Ce qui s'oppose, c'est la CI :
- Local : feedback immédiat, au moment de l'erreur.
- CI : la garantie. Le même
.pre-commit-config.yamlrejoué dans le pipeline.
Le bon montage est les deux, avec le même fichier de config :
# Étape de pipeline : ne vérifier que ce qui change, pas tout à chaque fois
pre-commit run --from-ref origin/HEAD --to-ref HEAD
C'est aussi l'endroit naturel pour la compilation réelle (ex. dbt parse/dbt build), qui échoue sur du code non compilable — ce qu'aucun contrôle de forme ne voit (par exemple un marqueur de conflit <<<<<<< oublié en plein SQL).