Sur les projets dbt qui grossissent, deux questions reviennent toujours : « quand faut-il séparer en plusieurs projets ? » et « qu'est-ce que dbt Mesh apporte pour ça, et combien ça coûte ? ». Les annonces marketing parlent de « Mesh » comme d'un produit ; la doc officielle dit pourtant le contraire : c'est un pattern, pas un produit. Restait à vérifier ce que ça change concrètement. J'ai donc monté sur un compte Snowflake un projet dbt à deux équipes en conflit volontaire, tourné avec dbt-core 1.12.4 (gratuit), et testé feature par feature : access: private, access: public, contracts, versions, et le fameux cross-project ref. Voici la frontière payante, testée à la main, ligne par ligne.
C'est quoi dbt Mesh, en deux minutes
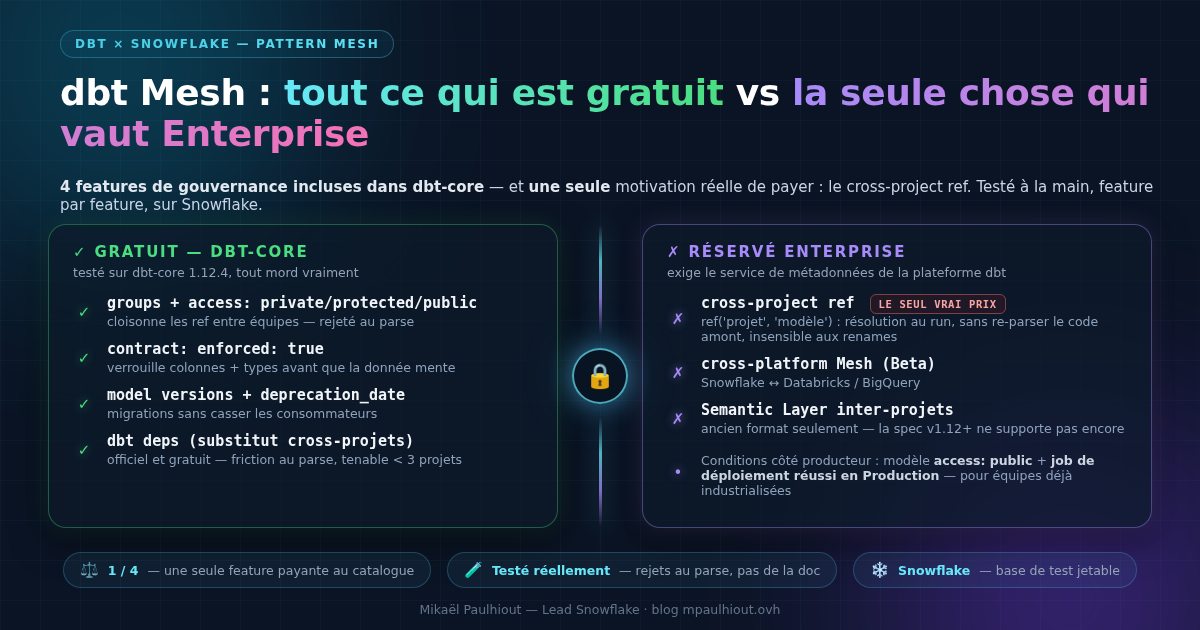
La phrase clé de la doc officielle : « Mesh is not a single product - it is a pattern enabled by a convergence of several features ». Ce n'est pas un produit, c'est un schéma d'organisation : plusieurs projets dbt indépendants qui référencent les modèles les uns des autres, gouvernés par quatre features :
| Feature | Rôle | Dispo dbt-core gratuit |
|---|---|---|
groups + access: private/protected/public |
cloisonner qui référence quoi entre équipes | ✅ |
Model contracts (contract: enforced: true) |
verrouiller la structure de sortie d'un modèle | ✅ |
Model versions (latest_version, deprecation_date) |
faire évoluer un modèle sans casser ses consommateurs | ✅ |
Cross-project ref (référence inter-projets) |
consommer le modèle d'un autre projet | ❌ Enterprise uniquement |
Tout sauf la dernière ligne est présent dans dbt-core depuis 2023 — avant même que le mot « Mesh » soit popularisé. Le produit payant apporte la mécanique de référence inter-projets (et son service de métadonnées) ; le reste, c'est de la gouvernance Core. C'est la frontière que les annonces n'expliquent presque jamais.
Le projet de test
Deux « équipes » dans un même projet dbt, avec un conflit voulu : finance expose un modèle, marketing tente de le référencer. Le projet tourne sur Snowflake (compte d'essai, base jetable), un modèle par groupe — assez pour tester chaque feature isolément. Tout tient en cinq fichiers et quelques minutes d'exécution.
Groupes et access : gratuit, et ça mord vraiment
Premier test : le modèle finance en access: private au groupe finance_team, et marketing qui essaie de faire un ref dessus.
# models/finance/finance_model.yml
models:
  - name: finance_model
    access: private
    group: finance_team
dbt build
# ❌ Rejeté au parsing :
# "not allowed because the referenced node is private to the finance_team group"Le blocage est réel, explicite, et se produit avant tout SQL. Je bascule le modèle en access: public, je relance : le build passe. Et le défaut (rien de déclaré) est protected : les références internes au projet passent, mais le modèle resterait hors d'atteinte pour un projet extérieur — vos projets existants ne changent rien et restent compatibles.
C'est un point souvent mal compris : la gouvernance d'accès ne demande aucun abonnement. Si votre seule raison de regarder Mesh est « empêcher l'équipe marketing de pointer sur nos tables finance », c'est réglé gratuitement.
Model contracts : le filet que je pose désormais avant chaque prod
Un contract, c'est la promesse : mon modèle expose ces colonnes, ces types, au-delà de la version du SQL. J'en déclare un sur le modèle finance, et je fais mentir la donnée — le modèle produit du TEXT, le contract annonce un NUMBER(38,0) :
columns:
  - name: revenue
    data_type: NUMBER(38,0)
contract:
    enforced: true
❌ "This model has an enforced contract that failed"
# Diagnostic table :
# column_name | definition_type | contract_type | mismatch_reason
# REVENUE | TEXT | FIXED | data type mismatchL'échec est propre, explicite, et sort avant que les consommateurs en aval aient consommé une donnée fausse. Ensuite, un contract respecté passe sans douleur. Deux limites honnêtes : les contracts ne s'appliquent pas aux sources, seeds et snapshots ; et sur une materialisation view Snowflake, seul le nom + type est contrôlé — un not_null déclarable n'y est pas appliqué (les contraintes vives ne tiennent que sur les tables). Pour la qualité des valeurs, mes 10 tests dbt systématiques restent le complément obligé.
Model versions : le filet de sécurité des refactorings
latest_version: 2 avec les versions v1 et v2 déclarées : dbt matérialise la version 2 sous le suffixe _v2, les références de vos consommateurs pointent la version qu'ils ont choisie, et vos migrations deviennent une affaire d'agenda, pas d'urgence. La deprecation_date (dbt-core 1.6+) joue le rôle de préavis : vous annoncez la date de mise à l'écart, vos consommateurs voient le warning chez eux, vous tuez v1 quand le silence est installé. Le compromis assumé : plus de matérialisations simultanées, à échanger contre des rollbacks sans casse pendant la fenêtre de transition.
La frontière payante : le cross-project ref
Le cœur de Mesh, c'est la référence entre projets. En dbt-core gratuit, avec un dependencies.yml pointant le projet upstream_project et la référence à deux arguments :
{{ ref('upstream_project', 'some_model') }}❌ "depends on a node named 'some_model' ... which was not found"En dbt-core, c'est une erreur définitive : la résolution inter-projets exige le service de métadonnées de la plateforme dbt (offre Enterprise). Ce que ce service apporte en plus : la résolution contre le environnement de Production du producteur (le consommateur n'analyse ni ne build jamais le code amont), et la continuité des ref même si le producteur renomme ou déplace ses modèles en amont. Les conditions côté producteur sont dures à avaler : le modèle ciblé doit être access: public et le projet producteur doit avoir au moins une exécution de job de déploiement réussie en environnement de Production. Autrement dit : le cross-project ref s'adresse aux équipes qui ont déjà industrialisé, pas aux projets en croissance qui se demandent si c'est le moment.
Même prudence sur la couche au-dessus : la nouvelle spécification du Semantic Layer (dbt v1.12+, métriques dans le YAML des modèles) ne supporte pas encore les références inter-projets — seul l'ancien format (fichiers de métriques séparés, spec top-level) les gère. Le cross-platform Mesh (un projet écrit dans un catalog Iceberg, un autre le lit depuis une autre plateforme — Snowflake ↔ Databricks/BigQuery) est en Beta : c'est aussi Enterprise.
Ce que propose le gratuit à la place : dbt deps
La substitution officielle et gratuite : packager le projet amont via dbt deps avec dbt_utils ou vos paquets internes.
Ça marche. Le coût est documenté par dbt eux-mêmes, et je le confirme :
| Aspect | Cross-project ref (Enterprise) | dbt deps (gratuit) |
|---|---|---|
| Résolution du code amont | au run, via le service de métadonnées | au parse local (dbt deps) |
| Vitesse de parse | sans charge du code amont | plus lent (tout le code amont est parsé) |
| Ce que build le run | le projet consommateur seulement | le code amont aussi |
| Variables et env vars du projet amont | sans objet (code jamais parsé) | à porter/aligner à la main |
Pour deux ou trois projets c'est tenable ; au-delà, c'est la friction qui finance le produit.
Les erreurs que j'ai faites pour vous
| Erreur | Symptôme | Correction |
|---|---|---|
Cru que access: private exigeait Enterprise |
N'ai appliqué les groupes nulle part | Testé : groupes + access fonctionnent en dbt-core gratuit, le ref privé est rejeté au parse |
| Référence à deux arguments dans dbt-core | node not found au parsing |
La mécanique vit sur la plateforme (Enterprise). En gratuit : dbt deps et packages |
| Contraintes (not_null) sur un contract en materialisation view | Déclaré, jamais appliqué sur Snowflake | Sur une view : nom + type seulement. La qualité passe par les tests dbt |
| Déployé groupes + contracts dès le jour 1 sur des modèles qui changeaient tous les mois | Rollbacks plus durs, maintenance en hausse | L'avis dbt : adopter progressivement, à l'échelle. D'abord access, contracts à maturité |
| Cherché le cross-project ref dans le nouveau format Semantic Layer (v1.12+) | Non supporté au parse | Nouveau format : pas encore. Ancien format (top-level) : oui — passer par l'ancien tant que le nouveau ne l'implémente pas |
Mon verdict : adoptez le gratuit maintenant, Enterprise attend son moment
Le readiness checklist de la doc — des modèles en si grand nombre que la performance dégrade, des équipes qui ont besoin de workflows découplés, des données partagées qui se dégradent, des exigences d'isolation qui montent — est le vrai déclencheur. Tant que vous n'y êtes pas : groupes, access, contracts et versions suffisent, et ils sont gratuits. Le jour où un second projet doit consommer un premier sans jamais re-parser son code et avec des renames qui ne cassent rien, alors le cross-project ref justifie l'abonnement — parce que ce qu'il achète, précisément, c'est le découplage du parse.
Si tu veux reproduire : le test tient en deux groupes, quatre modèles, un dependencies.yml, et tourne en quelques minutes sur n'importe quel compte Snowflake avec dbt-core 1.12.4 en gratuit. La base de test à nettoyer ensuite : DBT_MESH_TEST, jetable après coup.