Avec la sortie du moteur dbt Fusion (la réécriture complète en Rust) et la montée en puissance du Semantic Layer, j'ai voulu arrêter de lire des benchmarks de blog et me faire ma propre opinion. J'ai donc pris un compte Snowflake trial, monté un projet dbt minimal mais complet — un schéma e-commerce, 2 000 commandes, 4 métriques dont une dérivée — et je l'ai fait tourner sur dbt-core 1.12.4 et dbt Fusion 2.0.0-preview.218, côte à côte, mêmes modèles, même warehouse. Voici les chiffres réels, les pièges que j'ai rencontrés (et il y en a), et ce que je retiens pour la suite.
C'est quoi dbt Fusion, en deux minutes
dbt Fusion, c'est un moteur réécrit de zéro en Rust par dbt Labs (sur la base de la technologie SDF — une startup spécialisée dans la compréhension du SQL par machine, rachetée par dbt Labs). Trois promesses : l'exécution est beaucoup plus rapide que dbt-core, le moteur comprend le SQL de votre projet (donc attrape des erreurs avant le run), et il embarque nativement le Semantic Layer. Il est distribué via un installateur dédié (curl -fsSL https://public.cdn.getdbt.com/fs/install/install.sh | sh), l'installation place un binaire dbt qui remplace le CLI (command line interface, l'outil en ligne de commande) Python — et le binaire que j'ai installé ce mois est en 2.0.0-preview.218, donc officiellement au stade Preview du cycle de vie dbt : « stable et fonctionnellement prêt pour la production », mais pas encore Generally Available (disponible généralisée pour tous).
Premier point important que je n'avais pas compris avant de tester : Fusion et le Semantic Layer ne sont pas la même chose. Fusion est le moteur (exécution, parsing, diagnostics). Le Semantic Layer est une couche au-dessus, qui existe sous deux formes :
| Composant | Dispo | Licence |
|---|---|---|
MetricFlow (définitions + génération SQL + CLI mf) |
source-available, utilisable en local | Apache 2.0 |
| Service layer + APIs (GraphQL et JDBC — deux protocoles d'accès aux données —, exports, intégrations Tableau et Sheets) | offres dbt Cloud payantes (Starter et plus) | propriétaire |
En clair : vous pouvez définir et requêter vos métriques gratuitement en local (via MetricFlow), mais les intégrations BI (business intelligence — les outils de visualisation comme Tableau ou Power BI) et les exports passent par une offre payante dbt Cloud. C'est la frontière que personne n'explique clairement dans les annonces.
Le projet de test
Cinq clients (France, Belgique, Suisse), 2 000 commandes sur 2 ans, et un projet dbt volontairement classique : stg_customers, stg_orders, fact_orders, dim_customers, plus le modèle time_spine_daily exigé par le Semantic Layer. Le fact contient les colonnes qui nous intéressent : country_code, status, order_date, amount_euros.
Les modèles sont des views Snowflake générées par dbt, les deux moteurs produisent exactement le même SQL — j'ai comparé les fichiers compilés, ils sont identiques. C'est rassurant : Fusion ne réinvente pas la façon de compiler, il optimise autour.
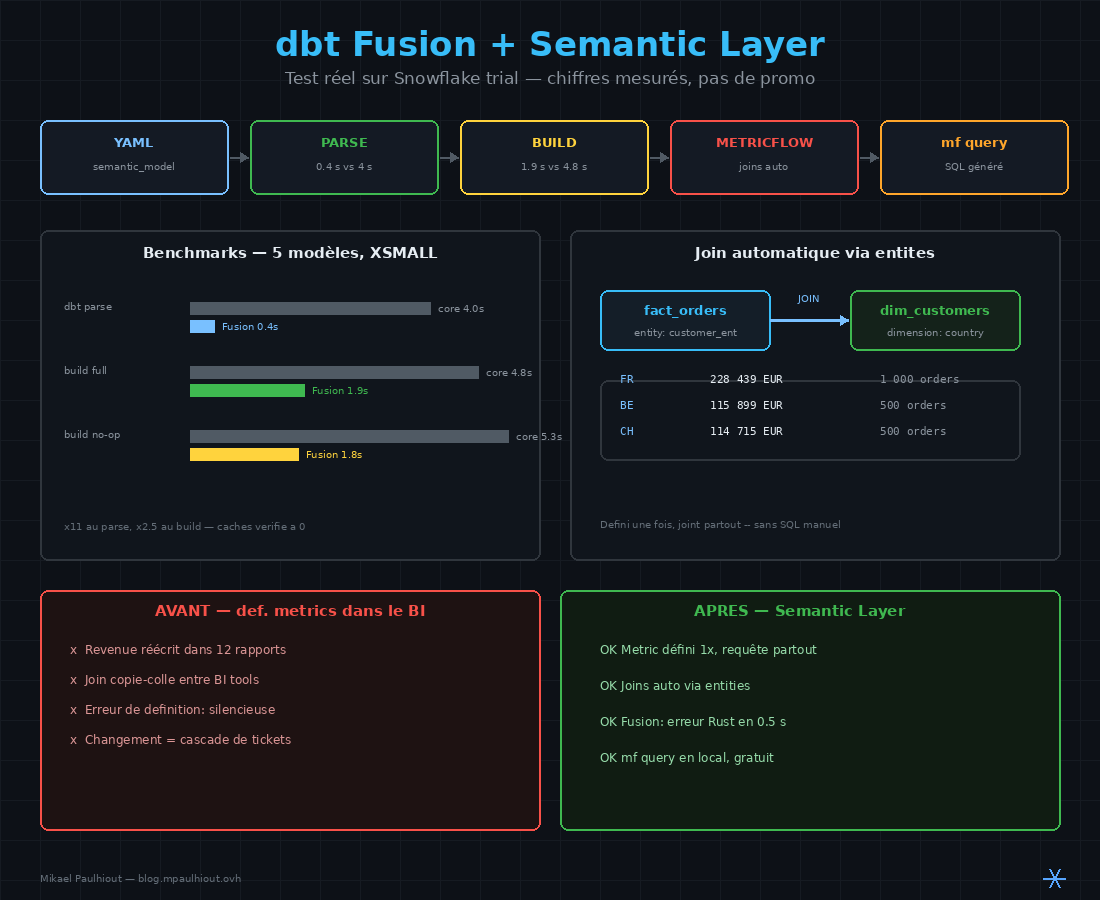
Benchmarks : Fusion est 2,5 à 11× plus rapide — biais de cache éliminé
Avant de vous donner les chiffres, une remarque de méthode. Ma première série de mesures avait un défaut que j'ai corrigé après coup : j'avais lancé dbt-core en premier, puis Fusion juste après. Si le cache de résultats Snowflake (qui garde les résultats de requêtes 24 h) jouait, le second moteur courrait sur des caches chauds et serait avantagé. J'ai donc refait l'expérience en alternant systématiquement les moteurs — core, fusion, core, fusion... — pour que les deux subissent exactement les mêmes conditions de cache, et j'ai vérifié côté Snowflake : sur les 291 requêtes des runs de mesure, 0 ont été servies depuis le cache (PERCENTAGE_SCANNED_FROM_CACHE à 0 partout — normal : dbt en full-refresh exécute du DDL, CREATE OR REPLACE VIEW, qui n'utilise jamais le result cache).
Mesures contrôlées, médianes de 3 runs alternés, même projet, même warehouse XSMALL :
| Opération | dbt-core 1.12.4 | Fusion 2.0.0-preview | Gain |
|---|---|---|---|
dbt parse (full, sans cache partiel) |
~4,0 s | ~0,4 s | ×11 |
dbt build (full-refresh, 5 modèles) |
~4,8 s | ~1,9 s | ×2,5 |
dbt build (rien à faire) |
~5,3 s | ~1,8 s | ×3 |
Le gain est spectaculaire sur le parsing — c'est le point annoncé, et il survit à l'élimination du biais de cache. Attention au biais d'échelle : sur un projet de 5 modèles, ces temps sont dominés par le démarrage des processus. Sur un projet de 2 000 modèles, l'écart absolu sera bien plus intéressant que ces chiffres, et le parsing incrémental de Fusion change la donne en développement. Mais dans les deux cas, la promesse est tenue — et maintenant, avec une méthode propre.
Le Semantic Layer en pratique
C'est la partie la plus intéressante, et la plus mal documentée. Trois étapes.
1. Annoter vos modèles en YAML
Le nouveau format (dbt v1.12+) définit tout dans les propriétés du modèle — plus de fichier séparé pour les mesures :
models:
  - name: fact_orders
    semantic_model:
      enabled: true
    agg_time_dimension: order_date
    columns:
      - name: order_id
        entity:
          type: primary
          name: order_ent
      - name: country_code
        dimension:
          type: categorical
          name: country
      - name: order_date
        granularity: day
        dimension:
          type: time
    metrics:
      - name: revenue
        type: simple
        agg: sum
        expr: amount_euros
      - name: order_count
        type: simple
        agg: count
        expr: order_id
Et une métrique dérivée, dans un fichier YAML séparé :
version: 2
metrics:
  - name: revenue_per_order
    type: derived
    type_params:
      expr: revenue / order_count
      metrics:
        - revenue
        - order_count
2. Le join automatique, là où la valeur est réelle
C'est le test qui m'a convaincu. J'interroge revenue groupé par la dimension customer_ent__customer_country — qui vit dans dim_customers, pas dans fact_orders. MetricFlow construit le join tout seul :
-- mf query --metrics revenue --group-by customer_ent__customer_country
SELECT
  dim_customers.country_code AS customer_ent__customer_country,
  SUM(fact_orders.amount_euros) AS revenue
FROM fact_orders
LEFT OUTER JOIN dim_customers
  ON fact_orders.customer_id = dim_customers.customer_id
GROUP BY 1;
Résultat réel : BE 115 899 €, CH 114 715 €, FR 228 439 € — vérifié à l'identique en SQL direct contre la table. Plus personne n'écrit ce join dans 12 rapports différents : l'entité est déclarée une fois, le SQL est généré une fois, la définition est partagée partout.
Le SQL ci-dessus est exactement ce que sort --explain, qui est devenu mon réflexe : voir le SQL généré avant de le faire tourner, et comprendre ce que MetricFlow a construit (le CASE WHEN order_id IS NOT NULL THEN 1 ELSE 0 END qu'il invente pour un count, par exemple, ne se devine pas).
3. La CLI mf, le chemin gratuit
Deuxième découverte importante : le CLI mf (auto-hébergé, sans offre dbt Cloud) est le chemin gratuit, et il est délicat à trouver. La commande dbt sl de Fusion route vers dbt Cloud (il exige un dbt_cloud.yaml), mais en local :
pip install dbt-metricflow   # installe le CLI `mf`
dbt parse                     # génère target/semantic_manifest.json
mf list metrics               # découvre métriques + dimensions
mf query --metrics revenue,order_count --group-by order_ent__country
mf validate-configs           # valide contre le warehouse (0 erreur = 0 surprise)
Les requêtes partent sur votre warehouse, les résultats reviennent dans le terminal (ou en fichier CSV — comma-separated values, format tabulaire texte — avec --csv). C'est fonctionnellement complet pour du développement : list metrics, query, validate-configs, --explain.
Les erreurs que j'ai faites pour vous
| Erreur | Symptôme | Correction |
|---|---|---|
Nommé mon entity order |
SQL compilation error: unexpected 'order' au mf validate-configs |
order est un mot réservé SQL — préfixez vos entités (order_ent) |
Cris input_metrics: sur une métrique derived (ancien format) |
Additional properties are not allowed ('input_metrics' was unexpected) à la parse |
Format v1.12 : type_params.expr + type_params.metrics: [...] |
| Zappé le time spine | Core 1.12 : warning « requires a time spine model » | Modèle time_spine_daily + bloc time_spine.standard_granularity_column: date_day en YAML |
Cherché le CLI dans metricflow pip |
No module named metricflow.cli |
Le CLI vit dans dbt-metricflow, pas dans metricflow (lib pure) |
mf direct après install |
« Unable to load the semantic manifest » | dbt parse d'abord (l'artefact semantic_manifest.json doit exister), et DBT_PROFILES_DIR si vos profiles ne sont pas dans le projet |
Nommé le fichier yml différemment du modèle (metricflow_time_spine.sql vs time_spine_daily en YAML) |
Warning « Unused schema.yml entry » | Le nom du fichier .sql doit correspondre au nom du modèle en YAML |
| Cru que Fusion remplaçait dbt Cloud pour le SL | Missing project in dbt_cloud.yaml avec dbt sl |
dbt sl = routing cloud. Le chemin local, c'est mf |
| Lancé core d'abord puis fusion (caches potentiellement chauds) | Benchmarks possiblement favorables au second moteur | Alterner les moteurs run par run + vérifier PERCENTAGE_SCANNED_FROM_CACHE (0 sur tous les runs) |
Le vrai gain de Fusion : attraper les erreurs avant le SQL
Le benchmark le plus parlant de mes tests n'est pas un temps de build, c'est celui-ci. J'introduis volontairement une faute de frappe dans une métrique (agg: summ au lieu de agg: sum) :
[error] YAML error: metrics[0].agg: unknown variant `summ`,
        expected one of `sum`, `min`, `max`, `count_distinct`, ...
0,5 seconde. Le moteur Rust a sérialisé le schéma de la spec métrique en énumérations Rust — une valeur inconnue est rejetée au parsing, avant toute connexion au warehouse. Le même projet sous dbt-core accepterait la parse (pas de validation de ce type), et l'erreur sortirait plus tard, côté SQL, avec un message moins explicite. Dans un CI qui build 500 modèles, c'est la différence entre échouer en 5 secondes et échouer après 10 minutes de run — c'est exactement le genre de retour de CI que vos équipes vont sentir au quotidien.
Ce que je n'ai pas testé (et que vous devriez vérifier)
Par honnêteté, ce projet de test est volontairement petit :
- Échelle : 5 modèles, 2 000 lignes. Les gains de parsing s'amplifient avec la taille du projet, mais je n'ai pas de chiffre au-delà.
- Exports et intégrations BI (Tableau, Google Sheets) : réservés aux offres dbt Cloud payantes, non testés ici.
- La migration d'un projet réel : j'ai testé un projet propre. Un projet existant avec des macros exotiques, des hooks ou du Jinja avancé méritera un audit de compatibilité (dbt fournit un outil d'analyse de compatibilité).
- Les unit tests et la couverture totale des specs — je me suis concentré sur le Semantic Layer, cœur de l'angle.
Le verdict
Fusion tient ses promesses de vitesse : parsing ×11 plus rapide, build ×2,5 plus rapide, diagnostics à la Rust qui transforment des erreurs silencieuses en messages précis en 0,5 s. Le Semantic Layer fonctionne réellement en self-hosted via mf — métriques, joins automatiques entre modèles, validation contre le warehouse — sans dépenser un centime de dbt Cloud, à condition de connaître les pièges (format v1.12 des métriques dérivées, time spine obligatoire, entités hors mots réservés).
Ce que je garde de ce test : le Semantic Layer est enfin utilisable gratuitement en développement local, et le jour où vos dashboards BI se brancheront dessus via les API (interfaces de programmation) Cloud, vos définitions ne changeront pas d'une ligne. Le reste — la vitesse de Fusion — est du confort qui devient vite une habitude. Je ne repartirais pas en arrière.
Si tu veux reproduire : dbt Fusion s'installe en une commande (curl -fsSL https://public.cdn.getdbt.com/fs/install/install.sh | sh), le projet de test tient en 5 fichiers, et un compte Snowflake trial suffit.