Il y a quelques semaines, l'équipe marketing m'a appelé en panique : leur tableau de bord indiquait 2,4 millions d'euros de chiffre d'affaires au lieu de 24 millions. Pas un bug d'affichage. Un champ amount avait changé de sémantique côté source, personne ne l'avait vu, et le rapport avait tourné deux jours sur des données fausses avant qu'un analyste ne remarque l'anomalie. Pas de test, pas de contrat, pas de propriétaire identifié. C'est exactement le scénario que les data contracts éliminent. Voici comment je les mets en place.
Le problème : des équipes qui se parlent par tickets
Quand plusieurs équipes consomment les données produites par d'autres, tout finit par reposer sur des hypothèses implicites. Le producteur change le sens d'une colonne, supprime un champ, ou modifie un format de date, et le consommateur s'en rend compte des jours plus tard, quand son rapport casse ou — pire — quand il a déjà tourné sur des données fausses.
Le pattern de communication dominant, c'est le ticket : "le champ status n'a plus les mêmes valeurs", "la table a un nouveau format de date". Un producteur qui ne sait pas exactement qui consomme quoi, des consommateurs qui n'ont aucun pouvoir sur ce que produit la table, et zéro garantie formelle. Chaque changement devient un événement à gérer dans l'urgence.
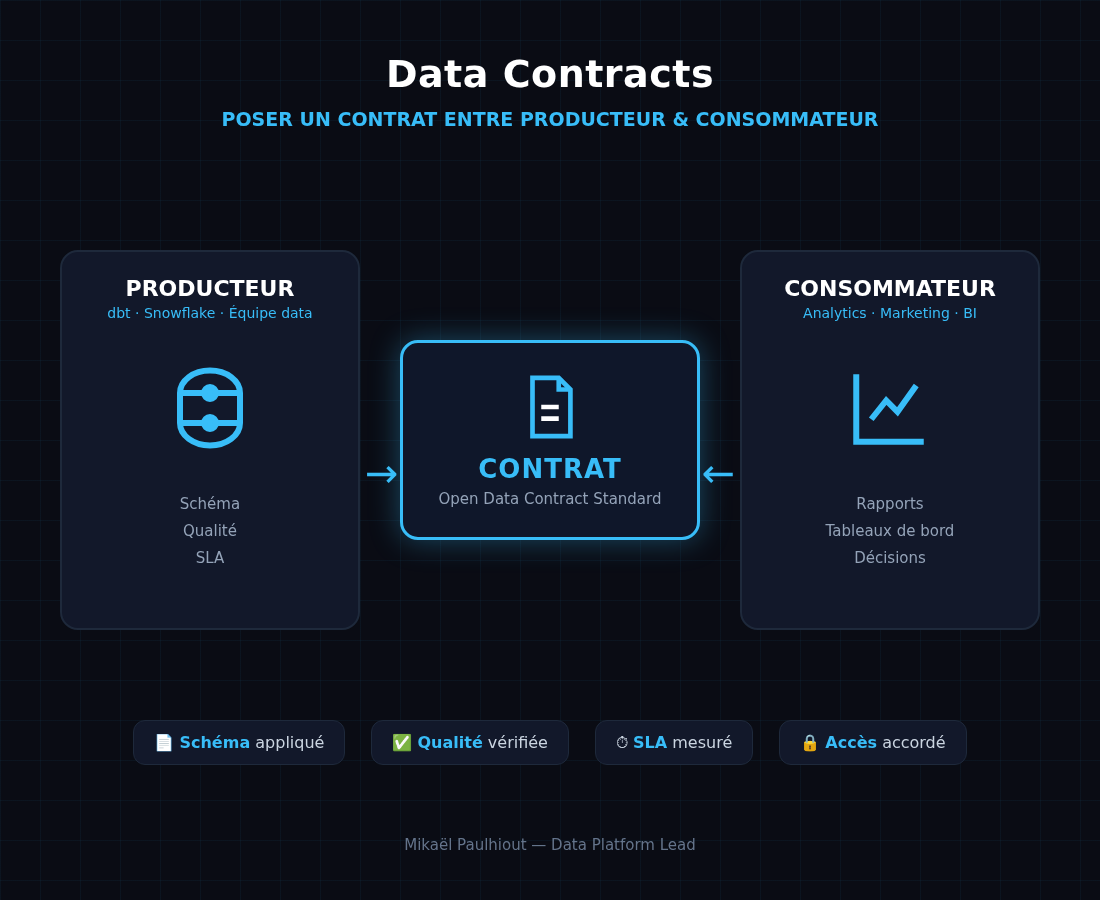
Un data contract est la réponse : un document structuré qui décrit formellement ce que le producteur s'engage à fournir (schéma, types, qualité, fraîcheur, disponibilité) et ce que le consommateur peut en attendre. Quand il est en place, un changement de schéma ne casse plus silencieusement un rapport — il est détecté au moment où le producteur veut l'appliquer.
Qu'est-ce qu'un data contract, concrètement
Il existe un standard ouvert pour ça : l'Open Data Contract Standard (ODCS), maintenu par Bitol sous licence Apache 2.0. Il définit les sections d'un contrat :
| Section | Contenu | Exemple concret |
|---|---|---|
| Fundamentals | Identité : domaine, data product, version, statut | domain: finance, version: 1.1.0 |
| Schema | Les tables et colonnes exposées | noms, types, clés, description métier |
| Data quality | Les règles de qualité et leurs seuils | taux de null, volume minimal |
| SLA | Disponibilité, fraîcheur, latence | données à jour à H-12, uptime 99.9% |
| Support & communication | Canaux de contact, propriétaire | email de l'équipe productrice |
| Pricing | Coût d'accès aux données (data mesh) | $ par octet, budget alloué |
| Team & Roles | Qui produit, qui consomme, qui est propriétaire | data owner, steward |
Tout le monde n'utilise pas ODCS — certains écrivent des contrats maison. Mais partir d'un standard a un avantage énorme : un format commun et validable, qu'on peut parser, versionner et vérifier en CI. Un contrat au format propriétaire ne tient pas la route à l'échelle.
Voici un exemple réaliste de contrat ODCS pour une table métier :
# data-contracts/customer_360.odcs.yaml
apiVersion: v3.0.0
kind: DataContract
id: 5f9c1a2e-0000-4000-8000-000000000001
domain: crm
dataProduct: customer_360
status: active
version: 1.2.0

# Fundamentals
description:
  purpose: Vue unifiée client pour les équipes analytics et marketing
  limitations: Données à J-1, pas d'historique temps réel

schema:
  - name: customer_360
    physicalType: table
    properties:
      - name: customer_id
        logicalType: string
        physicalType: varchar(36)
        primaryKey: true
        required: true
        description: Identifiant unique client (UUID v4)
        classification: restricted
      - name: email
        logicalType: string
        physicalType: varchar(255)
        required: true
        description: Email principal du client
        classification: restricted
      - name: created_at
        logicalType: timestamp
        physicalType: timestamp_ntz
        required: true
        description: Date de création du compte
      - name: segment
        logicalType: string
        physicalType: varchar(20)
        required: false
        description: Segment commercial (premium, standard, basic)

quality:
  - metric: nullValues
    mustBe: 0
    dimension: completeness
    severity: error
    schedule: "0 20 * * *"
  - metric: rowCount
    mustBeGreaterThan: 100000
    dimension: completeness
    severity: warn
    schedule: "0 20 * * *"

sla:
  - freshness: 24h
    severity: error

team:
  owner: data-platform
  contact: data-platform@monorg.com
Note : le contrat ODCS décrit ce qu'on promet. Il ne garantit pas à lui seul que ces promesses sont tenues. C'est là que dbt et Snowflake entrent en jeu — ils appliquent le contrat.
Appliquer le contrat avec dbt : les model contracts
Le meilleur endroit pour commencer, c'est là où les modèles sont définis : dans dbt. La fonctionnalité model contracts de dbt transforme le contrat YAML en contrainte réellement appliquée au moment du build.
# models/marts/customer/schema.yml
version: 2

models:
  - name: customer_360
    config:
      contract:
        enforced: true
    columns:
      - name: customer_id
        data_type: varchar
      - name: email
        data_type: varchar
      - name: created_at
        data_type: timestamp_ntz
      - name: segment
        data_type: varchar
Avec contract: enforced: true, dbt exige que chaque colonne ait un name et un data_type. Et surtout : au moment du dbt build, dbt ajuste automatiquement le SQL pour que la sortie respecte exactement le contrat (projection et casting vers les types déclarés). Si une colonne du modèle ne correspond pas au contrat, le build échoue — avant même que les données ne soient exposées aux consommateurs.
C'est le point clé : le contrat n'est plus une promesse écrite dans un YAML que personne ne lit. C'est une garde qui casse le déploiement quand la réalité du modèle s'écarte de l'engagement.
Ce que dbt applique vraiment
| Ce que le contrat dbt garantit | Mécanisme |
|---|---|
| Colonnes exactes, dans l'ordre | project + validation du nombre de colonnes |
| Types de données corrects | cast automatique vers data_type |
| Échec au build en cas d'écart | contract.enforced: true bloque dbt build |
| Nom du modèle stable | le contrat est lié au name du modèle |
⚠️ Le piège des types : Snowflake stocke certains types sous plusieurs alias (ex.
textvsvarchar). Le contrat dbt doit utiliser undata_typeque Snowflake comprend réellement, et cohérent avec ce que le modèle produit. Un mauvais cast au build peut forcer une conversion implicite coûteuse sur de grosses tables.
La fraîcheur : le SLA du contrat
Le contrat promet des données à J-1. Qui vérifie que c'est tenu ? Dans dbt, la configuration freshness sur les sources transforme la promesse SLA en contrôle automatisé.
# models/staging/crm/sources.yml
version: 2

sources:
  - name: crm_prod
    database: PROD
    schema: CRM
    freshness:
      warn_after: { count: 12, period: hour }
      error_after: { count: 24, period: hour }
    tables:
      - name: customer_360
        loaded_at_field: updated_at
La commande dbt source freshness vérifie que chaque source respecte son SLA. Si une table n'a pas été mise à jour depuis plus de 24h, c'est une erreur — le pipeline s'arrête et l'alerte part, au lieu que le consommateur découvre des données périmées dans son rapport.
Et côté Snowflake ? Les grants comme contrat d'accès
Un contrat ne dit pas seulement quoi — il dit qui peut y accéder. Côté Snowflake, la traduction concrète du contrat d'accès, ce sont les grants. Le principe : donner aux consommateurs exactement l'accès promis, rien de plus.
-- L'équipe analytics consomme le modèle customer_360 (couche mart)
GRANT USAGE ON DATABASE PROD_ANALYTICS TO ROLE ANALYTICS_ROLE;
GRANT USAGE ON SCHEMA PROD_ANALYTICS.MARTS TO ROLE ANALYTICS_ROLE;
GRANT SELECT ON TABLE PROD_ANALYTICS.MARTS.CUSTOMER_360 TO ROLE ANALYTICS_ROLE;

-- Futures tables de la couche mart : le contrat s'applique aussi aux nouvelles
GRANT SELECT ON FUTURE TABLES IN SCHEMA PROD_ANALYTICS.MARTS TO ROLE ANALYTICS_ROLE;
Le FUTURE GRANT est important : il garantit que toute nouvelle table de la couche mart est automatiquement lisible par l'équipe analytics — le contrat d'accès couvre le présent et le futur, sans intervention manuelle.
Le workflow : versionner le contrat comme du code
La clé de la réussite, c'est de traiter le contrat comme un artefact de code — pas comme un document Word qu'on met à jour quand on y pense.
- Le contrat vit dans le repo Git de l'équipe productrice (
data-contracts/). - Validation en CI : on valide le YAML contre le JSON Schema d'ODCS (le standard fournit le schéma officiel, importable dans l'IDE et utilisable en CI).
- Version sémantique : tout changement de schéma incrémente la version du contrat (
1.2.0→1.3.0). Un changement breaking (colonne supprimée, type modifié) impose une majeure et notifie les consommateurs. - dbt applique : le
schema.ymlde dbt reflète le contrat, aveccontract.enforcedet lafreshness. - Revue de changement : avant de merger un changement de schéma, on identifie les consommateurs référencés dans le contrat et on les informe.
# .gitlab-ci.yml — validation du contrat en CI
validate-contracts:
  script:
    - python validate_odcs.py data-contracts/   # valide vs JSON Schema ODCS
    - dbt parse                                 # valide les schémas dbt
    - dbt build                                 # applique contract.enforced + freshness
Le pipeline CI est le juge de paix : si le contrat casse, le merge est bloqué. Le consommateur n'apprend plus un changement de schéma en découvrant un rapport cassé — il est informé en amont, au moment du merge.
Les erreurs que j'ai faites pour vous
| ERREUR | CONSÉQUENCE | CORRECTION |
|---|---|---|
| Écrire un contrat sans l'appliquer | Document mort, personne ne le lit | Le relier à contract.enforced + freshness dbt |
| Contrat trop verbeux dès le départ | Personne n'ose le maintenir | Commencer par schéma + qualité + SLA, ajouter le reste après |
| Ignorer les types Snowflake réels | Casts implicites coûteux, échecs de build | Vérifier le data_type réel dans le contrat dbt |
| Pas de versionnement du contrat | Impossible de savoir qui consomme quoi, ni quand ça a changé | SemVer + le contrat dans Git, revu en merge request |
| Contrat propriétaire maison | Format non standard, non validable, non parseable | Adopter ODCS (standard ouvert Apache 2.0) |
Pas de FUTURE GRANT |
Nouvelles tables invisibles aux consommateurs | GRANT ... ON FUTURE TABLES systématique |
| Changer un type sans prévenir | Rapports qui cassent en production | Version majeure + notification des consommateurs |
| Le contrat décrit mais ne mesure pas | Promesse non vérifiée | freshness + règles quality appliquées |
Pourquoi commencer maintenant
Un data contract ne résout pas tout du jour au lendemain, mais il déplace le problème au bon endroit. Avant, un changement de schéma cassait un rapport en production et l'équipe marketing découvrait l'erreur des jours plus tard. Avec un contrat appliqué par dbt et vérifié en CI, la même erreur bloque le merge — le coût est immédiat, localisé, et connu de celui qui l'a causée.
La bonne nouvelle : tu n'as pas besoin de réécrire ton architecture. Le contrat se pose sur l'existant — sur les modèles dbt que tu as déjà (contract.enforced), sur les sources que tu as déjà (freshness), sur les grants que tu poses déjà (FUTURE GRANTS). C'est une couche de formalisation, pas une refonte.
Commence petit : prends une table critique consommée par plusieurs équipes, écris son contrat ODCS, applique-le dans dbt, et observe ce qui se passe au prochain changement de schéma. Je parie que tu ne reviendras pas en arrière — et que l'équipe marketing te remerciera.